

FlashAttention 的分块思路
标准 Attention 需要把完整的 分数矩阵写回 HBM,显存占用随序列长度平方增长。 FlashAttention 把 Q、K、V 分块载入 SRAM,在片上完成计算,避免物化完整的注意力矩阵。
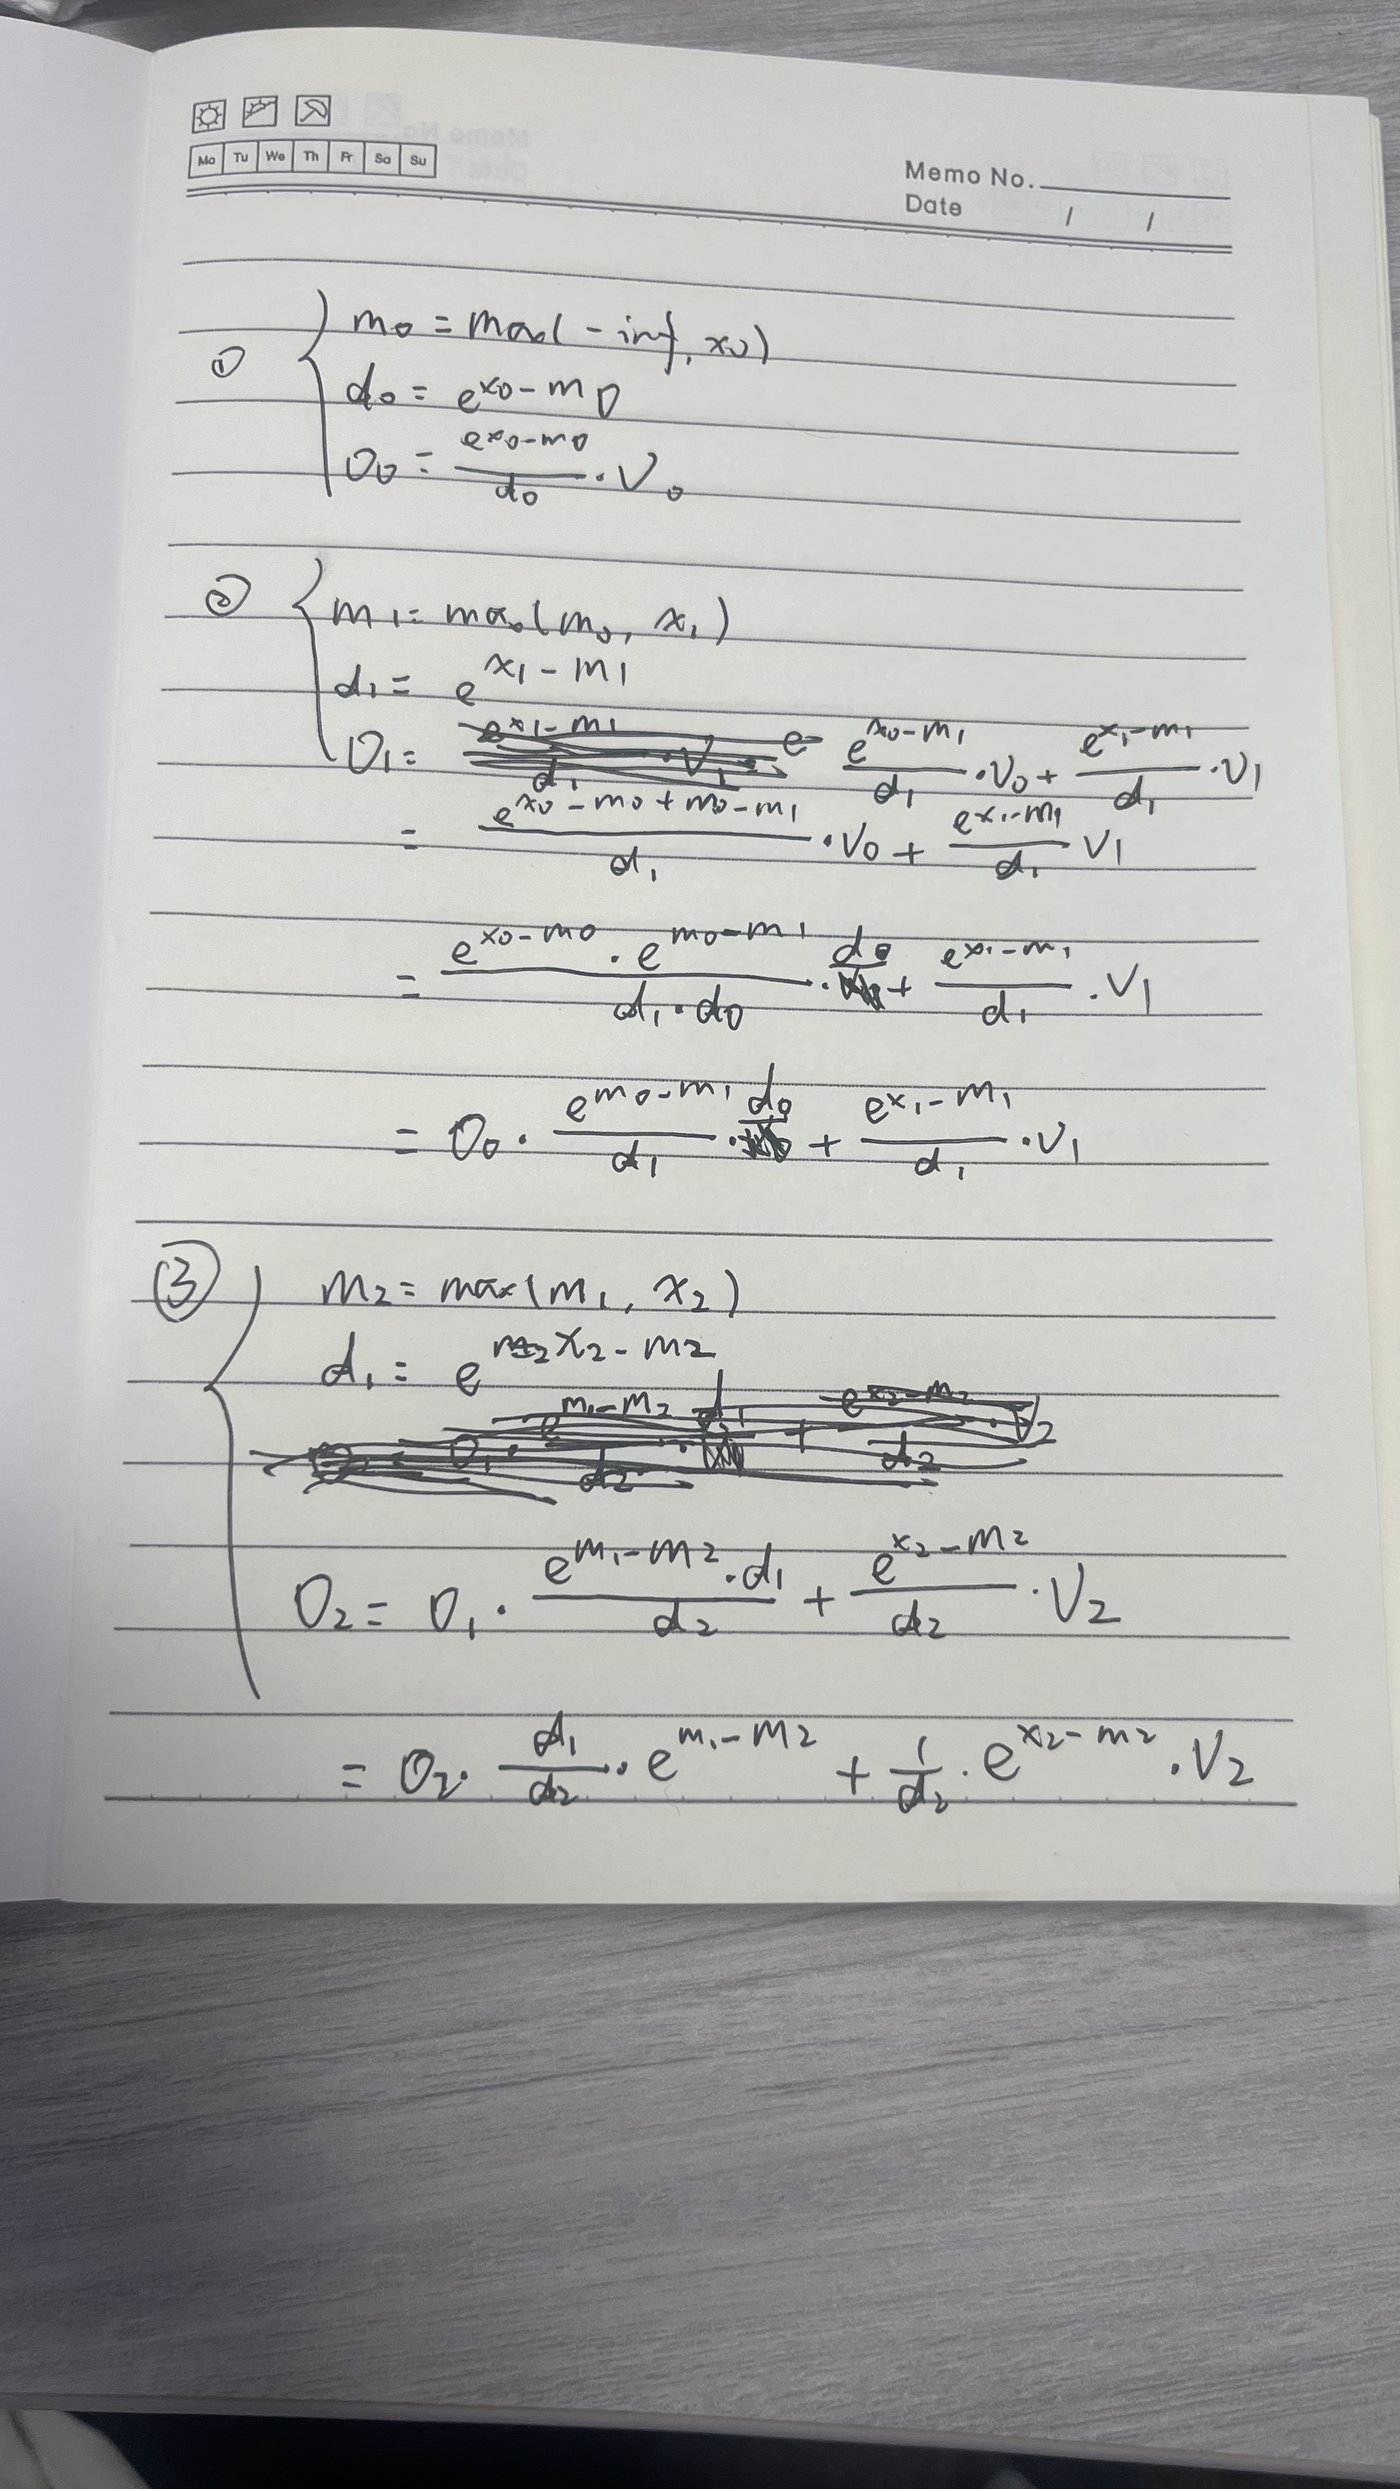
online softmax 的原理与公式推导

online softmax 与 value 的结合
分块计算时,每处理一个新的 K/V 块都要更新当前的 running max 与归一化因子,并对已累积的输出做相应缩放。
FlashAttention CUDA 算子实现

相关笔记
PagedAttention 与 KV Cache
Prefill 与 Decode 两阶段的计算特征,以及分页式 KV Cache 管理。
vLLM V1 新增特征
vLLM V1 在调度器、前缀缓存与张量并行上的架构演进。